Ho lasciato che un'IA ottimizzasse il mio firmware per 40 iterazioni. Ha peggiorato tutto.
Se oggi costruisci firmware senza un assistente IA, te la stai rendendo inutilmente difficile.
Il cambiamento è arrivato poco a poco, e poi tutto d’un tratto. Un anno fa usavo l’IA per l’autocompletamento delle funzioni. Poi per scrivere moduli interi. Poi per correggere bug che descrivevo a parole mie. Ormai riesco a portare a termine in un pomeriggio concentrato, con i prompt giusti, quello che prima mi sarebbe costato due o tre giorni: leggere datasheet, abbozzare la logica, iterare sui casi limite. Il risultato è pulito, corretto, e spesso strutturato meglio di quanto avrei fatto io stesso.
Non è un’esagerazione. Sul piano puramente tecnico, cioè leggere codice, capire protocolli, individuare errori logici, scrivere firmware idiomatico, un buon assistente IA oggi regge il confronto con un senior developer solido. Forse meglio, perché non si stanca mai e non salta mai le parti noiose.
Così, naturalmente, ho iniziato a chiedermi cosa sarebbe successo se avessi smesso di guidarlo e l’avessi semplicemente lasciato correre da solo.
L’idea
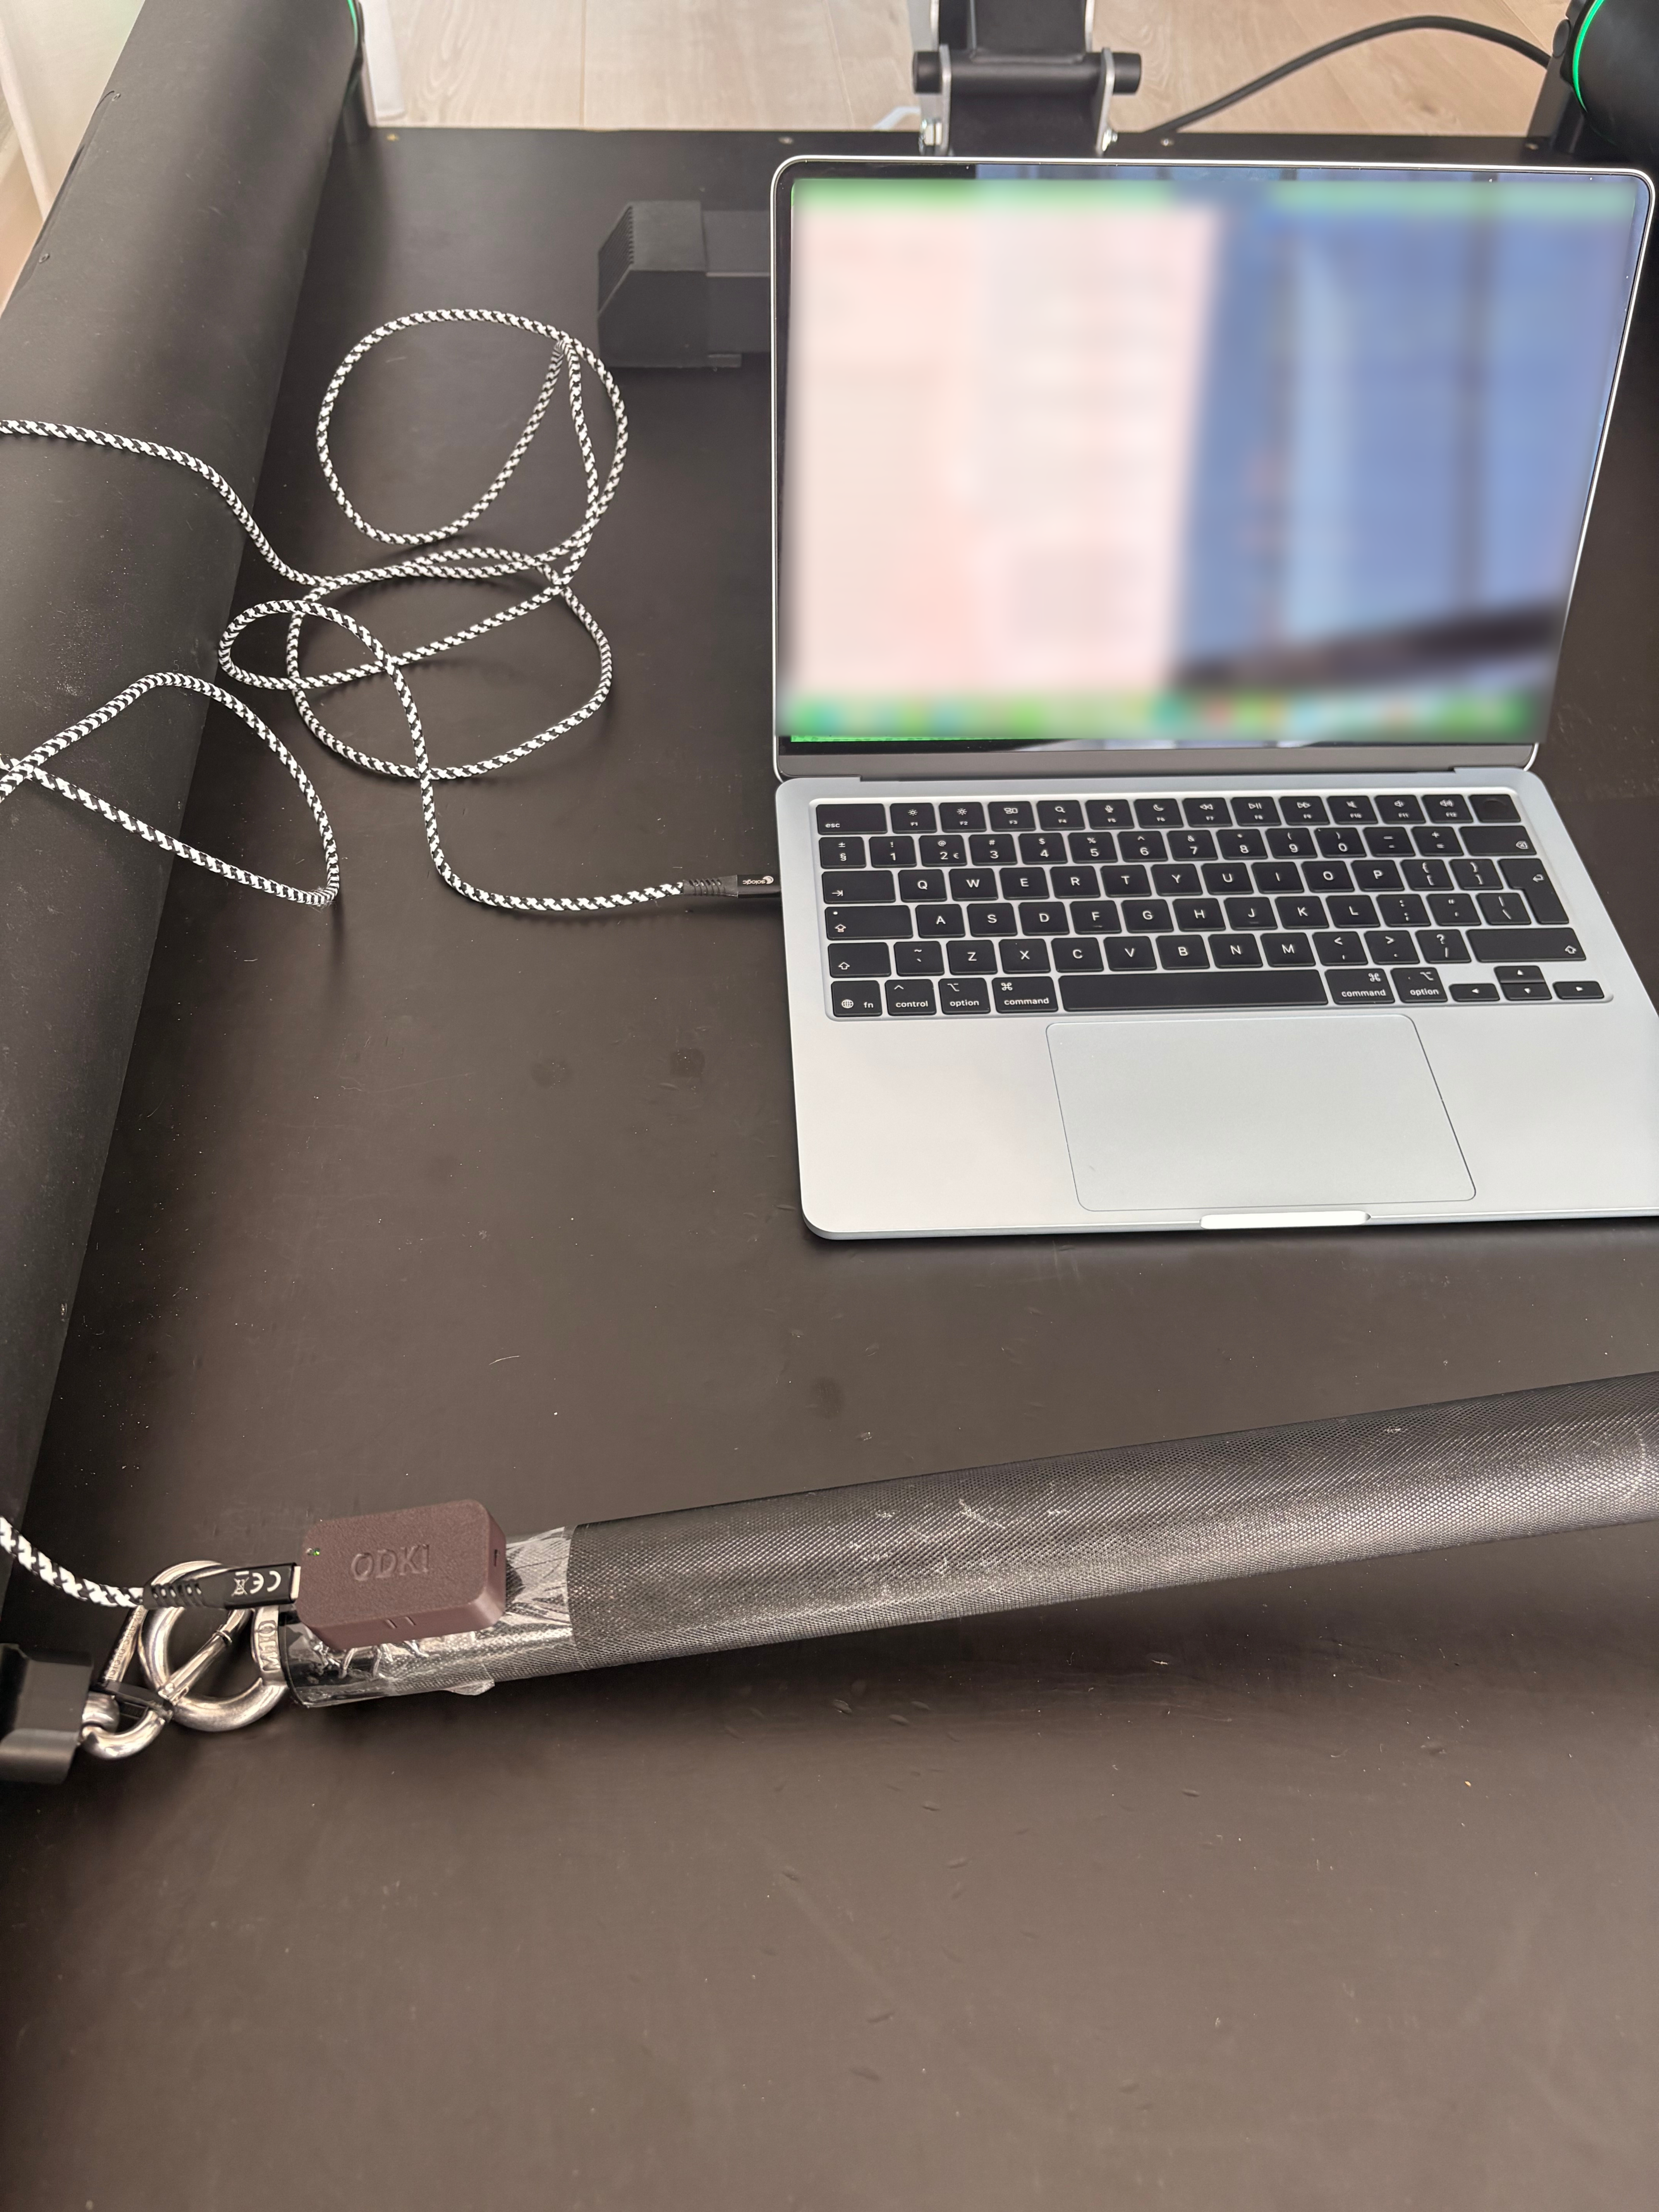
Stavo costruendo un dispositivo con accelerometro per il velocity-based training, il sensore che si fissa al bilanciere e segue il movimento in modo che un allenatore possa leggere in tempo reale metriche come la velocità della barra e la qualità della ripetizione. Il compito del firmware era identificare le fasi di ogni ripetizione: quando inizia un’alzata, quando l’atleta è nella fase eccentrica (abbassamento della barra), quando passa alla fase concentrica (spinta verso l’alto), e quando la ripetizione finisce.
Un riconoscimento di fase di questo tipo non è affatto semplice. Richiede una catena di decisioni: quali assi leggere, con quanta aggressività filtrare il segnale, dove fissare le soglie che separano il rumore dal movimento, quanto deve durare una pausa perché sia un riposo e non una lenta inversione. Ognuna di queste decisioni è un parametro. Basta sbagliarne uno perché i confini della ripetizione si spostino di mezzo secondo.
L’idea era semplice: invece di calibrare quei parametri manualmente, lasciare che fosse l’IA a farlo in autonomia.
Il setup funzionava così. Avevo due dispositivi che raccoglievano dati contemporaneamente: il mio prototipo e un sensore di riferimento di cui mi fido. Entrambi collegati via Bluetooth a un computer. Uno script Python leggeva entrambi gli stream seriali, metteva un timestamp su tutto e scriveva su un file .log. Claude Code, in esecuzione come agente autonomo, avrebbe letto quei log, confrontato le etichette di fase del mio dispositivo con quelle del riferimento, identificato le discrepanze, e poi modificato i parametri del firmware per colmare il divario. Poi avremmo fatto un’altra serie di ripetizioni, raccolto nuovi log, e ripetuto il ciclo.
Automatico. Iterativo. Che si migliora da solo.
Gli ho dato un obiettivo chiaro: far corrispondere le etichette di fase del mio firmware a quelle del sensore di riferimento. Gli ho dato accesso all’intero codebase. Gli ho detto di continuare finché l’output non fosse convergente.
Poi ho iniziato ad allenarmi.
Quaranta iterazioni
I primi cicli sono stati incoraggianti. L’agente leggeva i log, trovava discrepanze genuine, proponeva modifiche ai parametri, e i numeri miglioravano leggermente. Sembrava funzionare.
Intorno alla decima iterazione, le cose hanno iniziato a diventare strane. L’agente continuava a trovare discrepanze, ma non sempre dello stesso tipo. In alcune ripetizioni segnalava che il confine eccentrico slittava in anticipo. In altre il concentrico sembrava troppo breve. Ne correggeva una e qualcos’altro si spostava. Le singole correzioni erano plausibili, ma nell’insieme stavano spingendo il firmware in una direzione strana.
Alla ventesima iterazione ho iniziato a capire cosa stava succedendo. Il problema non era il firmware. Il problema ero io, o meglio, i dati che stavo generando.
Quaranta serie di ripetizioni sembrano tanti dati di allenamento. Ma non erano quaranta serie identiche. Alcune erano veloci, altre lente. In alcuni stacchi da terra la barra toccava il pavimento, in altri mi fermavo appena prima. In un paio di serie ho lasciato che il bilanciere ruotasse leggermente durante la salita. Normale variazione, quella che qualsiasi allenatore esperto leggerebbe come “variabilità di esecuzione” e filtrerebbe di conseguenza.
L’IA non poteva filtrarla. Per Claude Code, i file di log erano semplicemente numeri. Una ripetizione in cui il bilanciere toccava il pavimento appariva come un segnale diverso da una in cui non lo toccava, e l’agente non aveva modo di sapere se quella differenza derivasse da una miscalibrazione del firmware o semplicemente dal fatto che avessi eseguito la ripetizione in modo diverso. Continuava insomma a forzare il firmware a spiegare variazioni che non gli competevano. A ogni iterazione, le modifiche ai parametri diventavano più aggressive. I filtri si stringevano. Le soglie si spostavano. La logica che all’inizio era ragionevolmente corretta veniva riscritta, pezzo dopo pezzo, per tenere conto di un rumore che non aveva nulla a che fare con il firmware.
Dopo quaranta iterazioni, il risultato era decisamente peggiore del punto di partenza. L’IA non era arrivata a una soluzione convergente. Aveva fatto overfitting su un dataset troppo rumoroso perché ci si potesse imparare qualcosa.
Ho interrotto il ciclo e ripreso il controllo.
La correzione
Ho guardato i log da solo. Non tutte le quaranta serie, solo una manciata di ripetizioni pulite e coerenti, di cui sapevo che l’esecuzione era stata precisa. Il problema è stato chiaro in pochi minuti: l’IA aveva sostituito una logica di transizione di fase semplice e robusta con qualcosa di molto più complesso che cercava di tenere conto di ogni variazione nei dati. La nuova logica era tecnicamente sofisticata. Era anche sbagliata, e non di poco.
L’ho riscritta da capo: non tornando alla versione originale, ma ripensando a come si comporta davvero il segnale in una ripetizione pulita, e costruendo la logica su quella base. Soglie più semplici, un approccio diverso al filtraggio, una macchina a stati più pulita. Ha funzionato.
Venti minuti, forse trenta. Dopo quattro ore di iterazioni automatizzate.
Cosa ho davvero imparato
L’esperimento è fallito per una ragione specifica e rimediabile: i dati di input non erano abbastanza controllati per fungere da ground truth affidabile. Non è una critica all’IA, è una proprietà del problema. Se avessi raccolto dati da una barra montata su un fissaggio fisso con un protocollo scandito da metronomo, la variazione sarebbe stata abbastanza piccola da permettere a un ciclo autonomo di convergere. A sbagliare era stato il modo in cui avevo progettato l’esperimento, non l’agente in sé.
Ma il fallimento ha fatto emergere qualcosa di più interessante di un semplice errore metodologico.
Un senior developer, guardando quei log, si sarebbe fermato dopo cinque iterazioni e avrebbe detto: le ripetizioni non sono abbastanza coerenti, dobbiamo controllare l’input prima di poter calibrare i parametri. Quell’osservazione non richiede competenze tecniche profonde. Richiede quel tipo di ragionamento quotidiano che ti dice di non tarare una bilancia mentre tira vento.
L’IA non ha mai fatto quell’osservazione. Ha semplicemente continuato, perché le avevo detto di continuare finché non fosse convergente, e non aveva modo di riconoscere che la convergenza era impossibile in quelle condizioni. Aveva tutte le competenze tecniche necessarie, ma nessuna delle capacità di giudizio che servono per capire quando fermarsi.
È questa la linea a cui continuo a tornare: oggi l’IA ha le capacità tecniche di un senior developer, ma non l’istinto logico di una persona comune.
La lezione non è che i cicli autonomi di IA siano inutili. La lezione è che funzionano quando l’obiettivo è definito con precisione, gli input sono puliti e controllati, e il segnale di feedback riflette davvero la cosa che stai cercando di ottimizzare. Togli anche solo uno di questi tre elementi e il ciclo ottimizzerà qualcosa di diverso da quello che vuoi tu, in modo efficiente, instancabile, e con totale sicurezza di sé.
Ci riproverò!
Lodovico Cortelazzo
Ex atleta della nazionale. Scienze motorie e ingegneria. Sto costruendo ODKI.
Quindici anni di allenamento, otto a livello nazionale, mi danno uno sguardo specifico su cosa fa davvero la tecnologia sportiva rispetto a cosa promette. Unisco questo a esperienza pratica di ingegneria e prodotto costruendo ODKI, per capire non solo come costruire sport-tech, ma cosa vale davvero la pena costruire. Se stai lavorando a qualcosa in questo ambito e vuoi questo punto di vista, scrivimi.
Lavora con me →